Обслуживание серверов — это не «дежурство на случай аварии», а регулярный набор работ, который удерживает сервер в рабочем состоянии: мониторинг доступности и ресурсов, установка обновлений безопасности, резервное копирование с проверкой восстановления, контроль дисков и RAID-массивов, разграничение доступов и разбор инцидентов до того, как они повторятся. Услуга нужна бизнесу, у которого нет собственного круглосуточного дежурства: сайт, интернет-магазин, 1С, CRM или база данных уже влияют на выручку, а отказ почти всегда случается в неподходящий момент. Ниже — что именно входит в услугу, какой регламент считается нормой, сколько простоя вы покупаете вместе с уровнем SLA и какие рыночные диапазоны цен сложились в Украине в 2026 году.
Что входит в обслуживание серверов
Слово «обслуживание» каждый исполнитель трактует по-своему, поэтому состав работ надо фиксировать в договоре списком, а не фразой «поддержка сервера». Разница видна сразу: у одного подрядчика это только реакция на упавший сервис, у другого — плановые работы, которые предотвращают падение. Профессиональный вариант ближе ко второму и охватывает шесть направлений; тот же набор задач закрывает и поддержка серверов и облачной инфраструктуры.
- Мониторинг доступности и метрик: аптайм сервисов, загрузка процессора и памяти, свободное место, время отклика, очередь дисковых операций, состояние критичных служб.
- Патч-менеджмент: плановые обновления операционной системы, веб-сервера, СУБД и прикладного ПО с тестовым прогоном и понятным планом отката.
- Резервное копирование: расписание, глубина хранения, копия вне офиса, отдельная защищённая копия и регулярная проверка восстановления, а не только зелёный статус задания.
- Контроль оборудования: SMART-атрибуты дисков, состояние RAID, температура, блоки питания, источники бесперебойного питания и состояние вентиляции серверной.
- Безопасность: firewall, закрытие лишних портов, ключи вместо паролей, двухфакторная аутентификация для администраторов, сегментация сети, анализ журналов.
- Реакция на инциденты: разбор причины, устранение, восстановление из копии при необходимости и письменный вывод, чтобы сбой не повторился через месяц.
Отдельный пункт, который часто забывают в договоре, — отчётность. Работа, о которой заказчик не получает отчёта, неотличима от работы, которую не делали. Нормальный ритм: короткая сводка по инцидентам в течение суток и развёрнутый отчёт раз в месяц с трендами по нагрузке, месту на дисках и результатам тестов восстановления.
Чем обслуживание серверов отличается от хостинга и разовой настройки
Три разные услуги постоянно путают, и от путаницы страдает бюджет. Хостинг и серверы под проект — это предоставление мощностей и сети: виртуальная машина, выделенный сервер или место в стойке. Разовая настройка — это установка и конфигурирование стека под конкретную задачу, например разворачивание сервера под сайт, который делается в рамках разработки сайтов. Обслуживание — то, что происходит после: сопровождение, обновления, копии, мониторинг и реакция на сбои.
- Хостинг отвечает за доступность железа, сети и дата-центра, но не за вашу операционную систему, приложение и данные внутри сервера.
- Разовая настройка заканчивается актом и передачей доступов; через месяц сервер снова нужно обновлять, а никто этого уже не делает.
- Обслуживание — процесс с расписанием и ответственностью, его измеряют временем реакции и допустимым простоем, а не списком выполненных команд.
Регламент работ: что делают ежедневно, еженедельно и ежемесячно
Регламент — это то, что отличает процесс от импровизации. Он должен существовать письменно и выполняться по расписанию, потому что проверки «когда вспомним» не выдерживают рабочей нагрузки. Практичный каркас выглядит так.
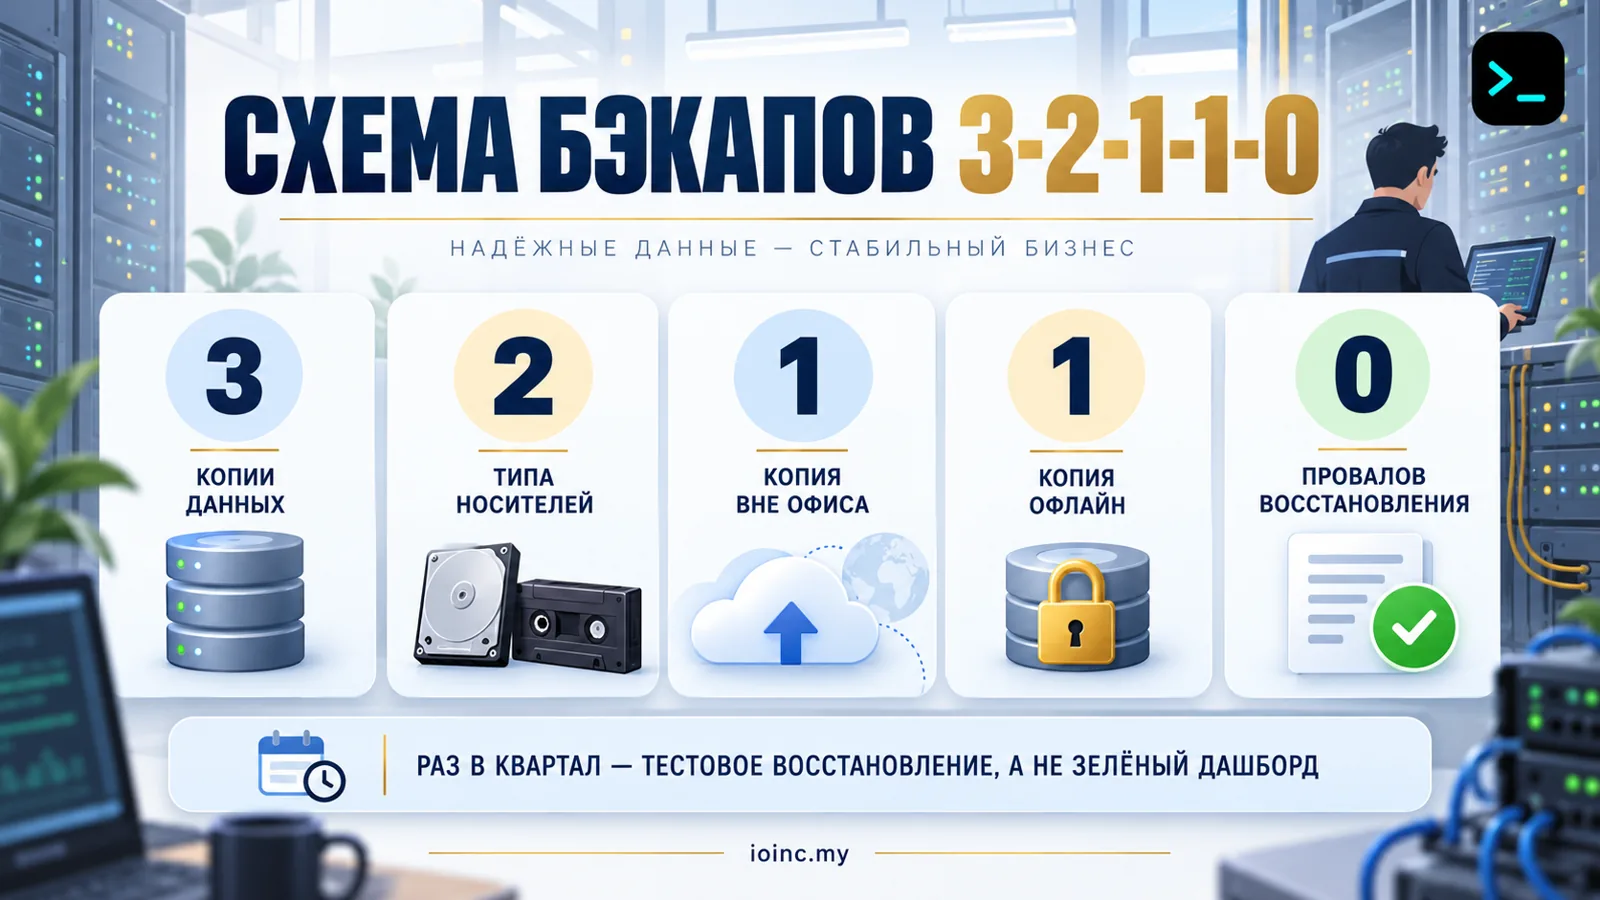
- Ежедневно: проверка алертов и журналов, контроль успешности заданий резервного копирования, свободное место на дисках, доступность ключевых сервисов и очереди задач.
- Еженедельно: критические обновления безопасности, состояние RAID и SMART-атрибутов, анализ трендов по нагрузке, проверка состояния антивирусной защиты и firewall.
- Ежемесячно: полное обновление ПО, тестовое восстановление одной критичной копии, проверка UPS и электропитания, аудит учётных записей и прав доступа, отчёт для руководства.
- Ежеквартально: аудит безопасности по эталонному профилю, пересмотр плана восстановления после сбоя, тест сценария переключения на резерв, планирование ёмкости на рост нагрузки.
SLA простыми словами: сколько простоя вы на самом деле покупаете
SLA (Service Level Agreement) — письменно зафиксированный уровень услуги: сколько времени допустимо сервис недоступен, как быстро подрядчик начинает работу и как быстро устраняет инцидент. Проценты звучат абстрактно, поэтому переводите их в часы и минуты — арифметика здесь простая: период умножается на долю допустимого простоя.
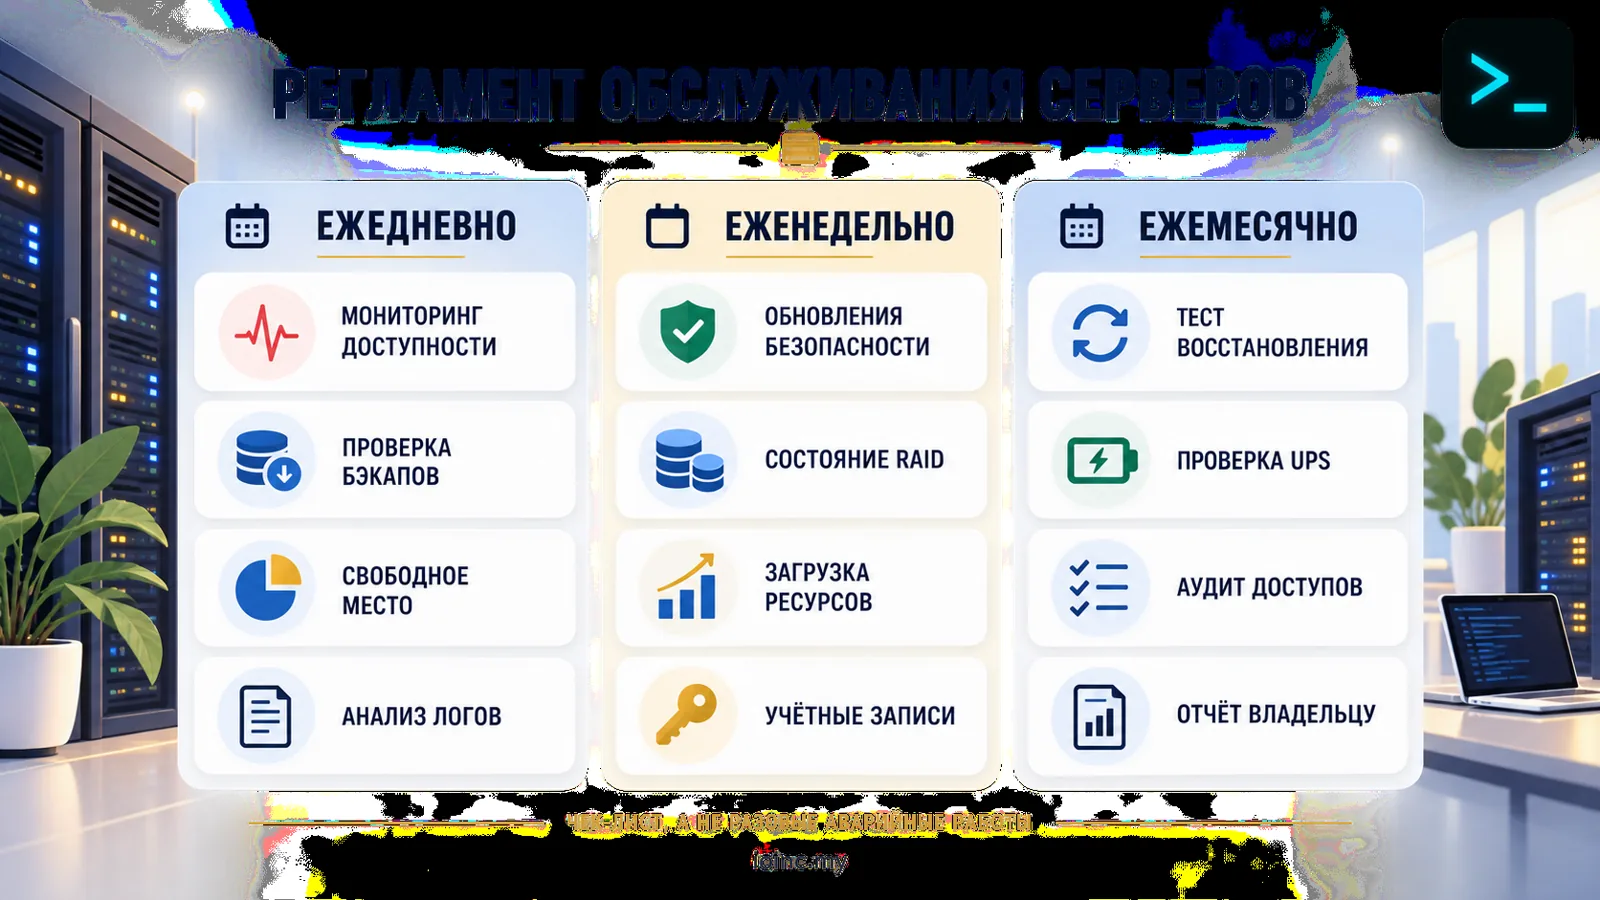
- 99,9 % — это 8,76 часа простоя в год, то есть 43,8 минуты в месяц; нормальный минимум для корпоративного сайта или сервиса, который не оплачивает простой деньгами.
- 99,95 % — 4,38 часа в год и 21,9 минуты в месяц; реалистичный ориентир для интернет-магазина и систем, где каждый час простоя означает потерянные заказы.
- 99,99 % — 52,6 минуты в год и около 4,4 минуты в месяц; на этом уровне ручная реакция уже не укладывается в бюджет — нужны автоматическое переключение и резервирование.
- 99,999 % — 5,3 минуты в год; пяти «девяток» достигают ценой распределённой инфраструктуры в нескольких зонах и постоянного дежурства, для большинства бизнесов это избыточно.
К уровню доступности прилагаются ещё две величины, которые стоит прописать отдельно. RTO — предельное время, за которое сервис должен быть восстановлен после сбоя, RPO — сколько данных допустимо потерять. Для системы учёта с ежемесячной отчётностью разумны RTO в несколько часов и RPO в один час; для архива и тестового контура цифры будут в разы мягче. Если этих значений в договоре нет, спор после аварии всегда сводится к разговору «так получилось». Замерять фактический аптайм нужно независимо от подрядчика — например, внешним сервисом мониторинга плюс счётчики приложения, которые как раз настраивает настройка аналитики и трекинга.
SLA без независимого замера — это обещание без доказательства. Подрядчик обязан показывать не отчёт о своих задачах, а фактический аптайм сервиса за месяц.
Патчи и уязвимости: сроки, которые имеет смысл прописать в договоре
Операционная система, веб-сервер, СУБД и прикладное ПО получают уведомления об уязвимостях непрерывно, и окно между публикацией уязвимости и попыткой её использовать измеряется днями. Эталонный ориентир — CIS Controls, где управление уязвимостями описано как непрерывный процесс: CIS Control 7 требует документированной процедуры управления уязвимостями и риск-ориентированного устранения с пересмотром не реже раза в месяц. Конкретные технические настройки берут из эталонных профилей CIS Benchmarks для нужной версии ОС и роли сервера. Прикладная часть этой работы обычно пересекается с DevOps-сопровождением инфраструктуры, если стек собирается в контейнерах и разворачивается автоматически.
- Уровень срока: критичные уязвимости, которые уже используют в атаках, закрывают в течение нескольких суток — это самый жёсткий пункт регламента.
- Плановый уровень: остальные обновления безопасности — в течение недель, по расписанию, с понятной ответственностью за срыв.
- Тестовый контур: обновления сначала прогоняют на копии стенда, затем выпускают в рабочий контур; для этого нужен план отката, а не надежда.
- Регулярная проверка: внутреннее и внешнее сканирование уязвимостей с отчётом, где видно не только найденное, но и фактически закрытое.
Бэкапы: правило 3-2-1-1-0 и проверка восстановления
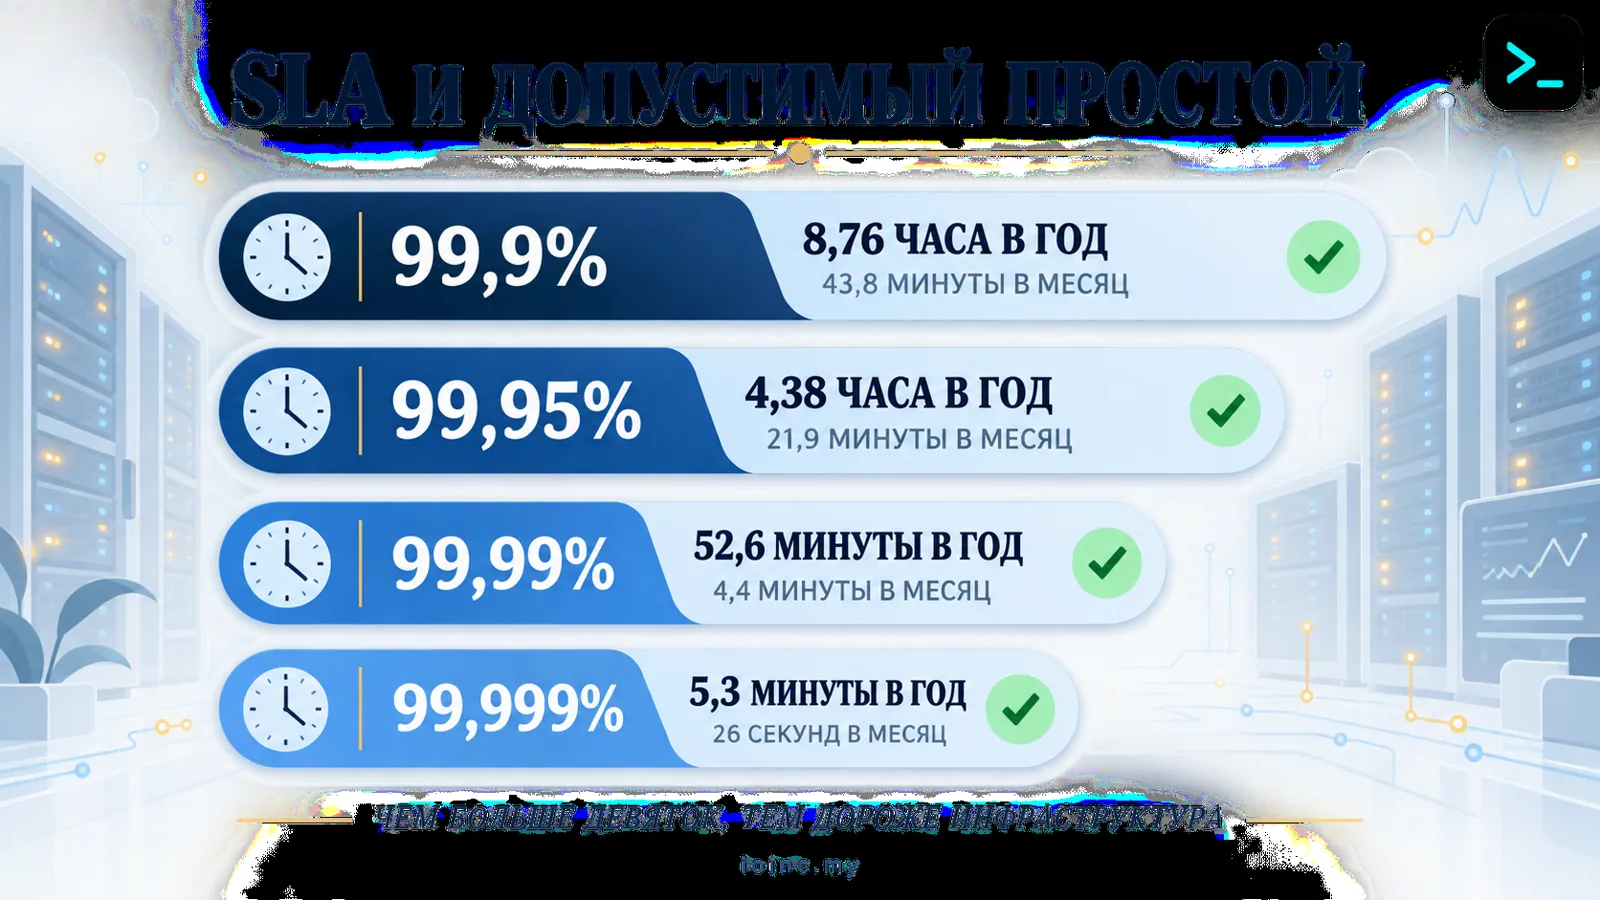
Резервная копия, из которой ни разу не восстанавливались, — это гипотеза, а не защита. Публичные рекомендации по защите от шифровальщиков прямо указывают: атакующие целятся в хранилища копий и гипервизоры, потому что уничтоженные бэкапы лишают организацию выбора. Отсюда рабочая схема 3-2-1-1-0: три копии данных, два типа носителей, одна копия вне офиса, одна копия в защищённом от изменений или отключённом хранилище и ноль провалов при тестовом восстановлении.
- Копии должны быть защищены от изменений и удаления со стороны той же учётной записи, которой пользуется администратор в обычной работе.
- Глубина хранения выбирается от RPO и требований отрасли: сутки, недели, месяцы — разные горизонты защищают от разных типов сбоев.
- Восстановление проверяют на отдельном стенде, чтобы не перезаписать рабочую систему во время теста.
- Хранение копий затрагивает персональные данные: доступ к ним ограничивают и фиксируют, иначе копии становятся каналом утечки.
- Для систем, где данные разбирают алгоритмами — от антифрода до прогноза отказов оборудования — сценарии полезно продумать заранее, как это делается во внедрении нейросетей.
Сколько стоит обслуживание серверов в Украине в 2026 году
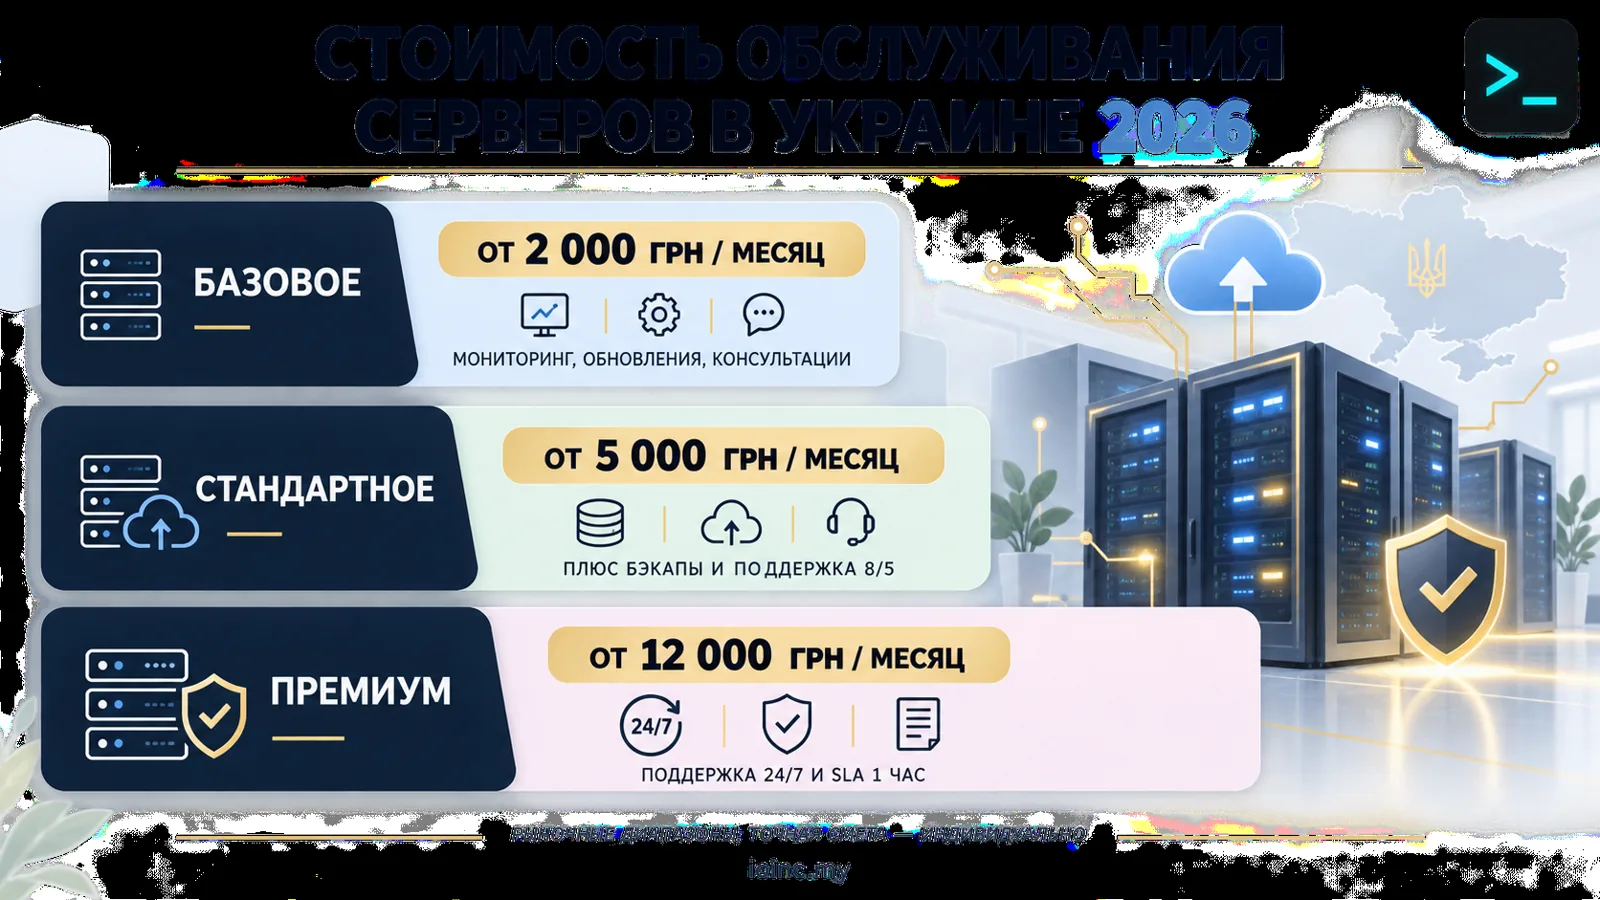
Цена складывается из объёма работ, количества серверов, требований к скорости реакции и сложности стека. Разница между «мониторить пинг» и «обслуживать кластер с базой данных, балансировщиком и резервным контуром» — кратная, поэтому пакеты отличаются не косметически, а набором задач. Ориентиры по открытым прайсам украинских агентств и провайдеров на начало октября 2026 года такие.
- Базовое обслуживание одного сервера — от 2 000 грн в месяц: мониторинг, обновления, консультации без круглосуточной поддержки.
- Стандартное обслуживание — от 5 000 грн в месяц за один-три сервера: добавляются резервное копирование, контроль безопасности и поддержка в рабочие часы.
- Премиум — от 12 000 грн в месяц: круглосуточная поддержка, время реакции до часа и расширенный SLA.
- Полный аутсорсинг инфраструктуры — от 20 000 грн в месяц; отдельный рынок — почасовая работа: открытые тарифы встречаются в диапазоне от 25 до 45 долларов за час.
Точная смета зависит от сложности инфраструктуры и рассчитывается индивидуально: значение имеют количество сервисов, критичность данных, требования к доступности и то, придётся ли подрядчику разбираться с наследством предыдущего администратора. Полезно помнить, что обслуживание — не единственная переменная: в июне 2026 года ряд европейских провайдеров поднимал цены на аренду выделенных серверов, поэтому бюджет на инфраструктуру стоит пересматривать вместе с тарифом обслуживания.
Когда нужен внешний подрядчик, а когда хватит штатного администратора
Вопрос не в модности аутсорсинга, а в том, сколько несовместимых ролей может закрыть один человек. Круглосуточное дежурство, плановые обновления по всему парку серверов и регулярные проверки восстановления одновременно — это три отдельные компетенции; один специалист физически закрывает две из трёх, а третья тихо проваливается.
- Внешний партнёр оправдан, когда сервисы зависят от работоспособности круглосуточно, а сбои случаются и в отпуске, и на больничном у штатного администратора.
- Штатный специалист сильнее в задачах, которые требуют знания предметной области: логика приложения, интеграции, специфика учётной системы.
- Смешанная модель часто разумнее: внутренняя команда занимается продуктом, подрядчик — мониторингом, обновлениями, копиями и реакцией на инфраструктурные сбои.
- Если вся инфраструктура держится на одном человеке без документации, риск выше, чем стоимость обслуживания: восстановление начнётся с изучения незнакомой системы.
Как выбрать подрядчика: вопросы, на которые нужен ответ до договора
Требования к исполнителю проверяются не презентацией, а прямыми вопросами, на которые есть конкретный ответ. Если ответ сводится к «мы всё делаем», значит, регламента нет. Если инфраструктуру сначала нужно оценить, разумный первый шаг — аудит digital-проекта, по итогам которого видно состояние серверов, копий и учётных записей.
- Что вы включите в договор и какие работы из регламента выполняются по расписанию, а не по запросу?
- Какой аптайм вы подтверждаете и чем его измеряете — своим отчётом или внешним сервисом?
- Сколько времени занимает реакция в рабочие часы, ночью и в выходные, и как это зафиксировано?
- Как часто обновляется ПО и что происходит при неудачном обновлении — есть ли план отката?
- Как устроены резервные копии, где хранится вторая копия и когда проводился последний тест восстановления?
- Как передаются доступы: отдельные учётные записи, ключи, двухфакторная аутентификация, журнал действий?
- Что входит в отчёт: инциденты, тренды нагрузки, свободное место, закрытые уязвимости?
- Как передаются знания и документация, если сотрудничество прекращается?
Типичные ошибки заказчиков
Большинство аварий, которые видно со стороны, начинаются не с поломки железа, а с решений на этапе выбора услуги. Самые дорогие ошибки повторяются из года в год.
- Покупать обслуживание только после крупной аварии: восстановление без подготовленной копии обходится кратно дороже года плановых работ.
- Сводить услугу к мониторингу «жив ли порт»: сервер может быть доступен, пока приложение не принимает заказы.
- Не проверять восстановление копий и узнавать об их неработоспособности в момент аварии.
- Отдавать все доступы одной учётной записи администратора без разделения прав и двухфакторной аутентификации.
- Экономить на электропитании и резервном питании серверной: нестабильное питание и отключения повреждают файловые системы и массивы.
- Оставлять документацию только в голове подрядчика: при смене исполнителя восстановление превращается в археологию.
Украинская специфика: питание, кадры и кибератаки
Для украинской инфраструктуры базовый регламент нужно расширять. По данным CERT-UA, в первом полугодии 2026 года зафиксировано 3 137 киберинцидентов — на 8 % больше, чем в предыдущем полугодии. Практический вывод простой: обновления, сегментация и защищённые копии перестали быть параноидальной опцией и стали гигиеной, которую проверяют по факту инцидента, а не по обещанию.
Второй фактор — условия эксплуатации. Перебои с электропитанием в местах размещения оборудования переносят акцент на UPS, контроль качества питания и корректное завершение работы сервисов. Третий — кадровый риск: когда единственный специалист выпадает из процесса, инфраструктура остаётся без сопровождения, поэтому документация и передача знаний должны быть частью услуги, а не бонусом. Четвёртый — требования закона: статья 24 Закона Украины «Про захист персональних даних» обязывает владельца и распорядителя данных обеспечивать их защиту, включая защиту от случайной потери, уничтожения и незаконного доступа. Для практики это означает ограничение доступа к серверам, защищённые копии и режим журналирования — те же пункты, что и в разделах про безопасность и бэкапы. Если на серверах работают учётные системы, требования удобно проверять вместе с внедрением CRM: там видно, кто и к каким данным имеет доступ.
Как принять работу и что требовать в отчёте
Обслуживание — услуга, которую невозможно проверить один раз при передаче, поэтому контролировать её нужно ежемесячно и по документам.
- Отчёт о фактическом аптайме за период с источником замера, а не общий комментарий о стабильности.
- Список выполненных по регламенту работ с датами: патчи, проверки, тесты восстановления.
- Журнал инцидентов: что произошло, как быстро отреагировали, что изменили, чтобы не повторилось.
- Результат последнего теста восстановления с указанием системы, копии и затраченного времени.
- Актуальная документация: схема инфраструктуры, список сервисов, доступы и контакты ответственных.
Итог
Обслуживание серверов окупается не экономией на администраторе, а предсказуемостью: понятным регламентом, проверяемыми копиями и временем реакции, которое не зависит от отпуска одного человека. Выбирая исполнителя, спрашивайте про аптайм, копии и доступы — именно там видны реальные различия между пакетами. Работоспособность инфраструктуры влияет и на позиции: недоступные страницы теряют трафик, поэтому сопровождение серверов стоит рассматривать вместе с SEO-продвижением, а не отдельно от него.
Проверим вашу инфраструктуру и предложим регламент обслуживания серверов
Частые вопросы
Что входит в абонентское обслуживание серверов?
Мониторинг доступности и ресурсов, плановые обновления и патчи безопасности, резервное копирование с проверкой восстановления, контроль дисков, RAID и электропитания, управление доступами, разбор инцидентов и ежемесячный отчёт. Состав работ фиксируется в договоре списком, а не общим словом «поддержка».
Можно ли обслуживать сервер только удалённо?
Да, большинство задач решается удалённо: обновления, мониторинг, копии, конфигурация, восстановление сервисов. Физическое присутствие нужно редко — для замены диска, блока питания или работ в конкретной серверной. Если оборудование стоит в офисе, важно заранее договориться, кто выполняет такие работы и в какие сроки.
Сколько стоит обслуживание серверов в Украине в месяц?
По открытым прайсам украинских агентств и провайдеров на октябрь 2026 года базовое обслуживание одного сервера начинается от 2 000 грн в месяц, стандартное с копиями и поддержкой в рабочие часы — от 5 000 грн, премиум с круглосуточной поддержкой — от 12 000 грн. Точная смета зависит от сложности инфраструктуры и рассчитывается индивидуально после аудита.
Что такое SLA и какой уровень реалистичен для малого бизнеса?
SLA — письменное соглашение об уровне услуги: допустимый простой, время реакции и время устранения инцидента. Для малого бизнеса реалистичен уровень 99,9 % — это 8,76 часа простоя в год или около 44 минут в месяц. Уровни 99,95 % и выше требуют резервирования и автоматического переключения, поэтому их цена существенно выше.
Чем обслуживание серверов отличается от хостинга?
Хостинг предоставляет железо, сеть и дата-центр, отвечая за доступность инфраструктуры до уровня виртуальной машины. Содержимое сервера — операционная система, приложение, база данных, копии и обновления — остаётся зоной ответственности владельца или его подрядчика по обслуживанию. Провайдеры обычно прямо указывают, что администрирование в услугу не входит.
Нужен ли штатный администратор, если есть подрядчик?
Не обязательно. Разумнее разделить роли: подрядчик отвечает за мониторинг, обновления, копии и реакцию на инфраструктурные сбои, а внутренний специалист занимается продуктом, интеграциями и предметной логикой систем. Ключевое условие — чтобы инфраструктура не зависела от знаний одного человека: документация должна существовать на бумаге, а не в голове.
Как часто нужно обновлять серверное ПО и закрывать уязвимости?
Критичные уязвимости, которые уже используют в атаках, закрывают в течение нескольких суток; остальные обновления безопасности выпускают по расписанию в течение недель. Эталонный ориентир — CIS Control 7, где управление уязвимостями описано как непрерывный процесс с риск-ориентированным устранением и пересмотром не реже раза в месяц. Обновления сначала прогоняют на тестовом контуре.
Как проверить, что резервные копии действительно работают?
Единственный способ — регулярно восстанавливаться из копии на отдельном стенде и фиксировать результат: какой сервис, какая копия, сколько времени заняло. Схема 3-2-1-1-0 прямо включает ноль провалов восстановления как обязательное условие. Зелёный статус задания в панели бэкапов доказывает только то, что задание запустилось.
Что делать, если сервер уже упал и данных нет?
Сначала остановить запись новых данных на повреждённые носители, чтобы не потерять шанс на восстановление файловой системы, и определить, какие копии доступны и насколько они свежие. Затем восстановить сервис из последней работоспособной копии и параллельно разбирать причину. Отдельная задача — проверить, не затронуто ли хранилище копий: в атаках на инфраструктуру бэкапы часто становятся первой целью.
Обязателен ли аудит безопасности сервера для украинского бизнеса?
Прямого требования «пройти аудит» в законодательстве нет, но статья 24 Закона Украины «Про захист персональних даних» обязывает владельца и распорядителя данных обеспечивать их защиту от случайной потери, уничтожения и незаконного доступа. Практически это означает ограничение доступа к серверам, защищённые копии и журналирование действий. Компании, работающие с чувствительными данными, дополнительно ориентируются на отраслевые требования.
Как безопасно передать подрядчику доступ к серверу?
Персональные учётные записи вместо общей, аутентификация по ключам и двухфакторная аутентификация, минимально необходимые права, запрет прямого входа под суперпользователем, журналирование действий и возможность отозвать доступ в любой момент. Хорошая практика — отдельный доступ для аварийных работ с повышенными правами, который выдаётся на время и фиксируется в журнале.
Как быстро подрядчик должен реагировать на инцидент?
Это предмет договора, и цифры различаются по пакетам: в базовых вариантах реакция идёт в рабочие часы, в премиум-пакетах время реакции сокращается до часа и действует круглосуточно. Важно, чтобы сроки были записаны для инцидентов разного уровня — полный отказ сервиса, деградация производительности, плановый запрос — потому что «реакция в течение часа» без градации на практике превращается в неопределённость.
Поможет ли UPS при отключении электроэнергии?
UPS решает две задачи: короткие перепады и отключения, за время которых сервер успевает корректно завершить работу, и защиту от скачков напряжения. Он не заменяет генератор и не спасает при длительном отключении, поэтому в регламенте нужны проверка батарей, тест перехода на питание от батарей и корректное завершение сервисов, а не просто факт наличия устройства в стойке.
Когда сервер пора переносить в облако или менять на новый?
Ориентиры простые: оборудование старше пяти-семи лет без расширенной поддержки, регулярные отказы дисков, невозможность обновить операционную систему до поддерживаемой версии, нехватка ресурсов под текущую нагрузку. Иногда дешевле остаться на месте и продлить поддержку платной подпиской, иногда — переехать в облако; решение считается по пятилетней стоимости владения, а не по цене аренды за месяц.
Как оценить работу подрядчика по итогам месяца?
Смотрите на факты, а не на активность: фактический аптайм за период с источником замера, долю закрытых по регламенту работ, срок реакции по инцидентам, результат последнего теста восстановления и актуальность документации. Отдельный показатель — повторяемость инцидентов: если одна и та же проблема возвращается месяц за месяцем, значит, разбор причин не выполняется.