Сбор семантического ядра — это не составление списка ключевых слов, а построение карты спроса: какие формулировки люди вводят в поиске, что за ними стоит и какая страница сайта должна на них отвечать. Собирают его в шесть шагов: маркеры, источники фраз, частотность, чистка, кластеризация по выдаче и распределение по страницам. На выходе получается не файл на несколько тысяч строк, а структура сайта и контент-план на квартал вперёд.
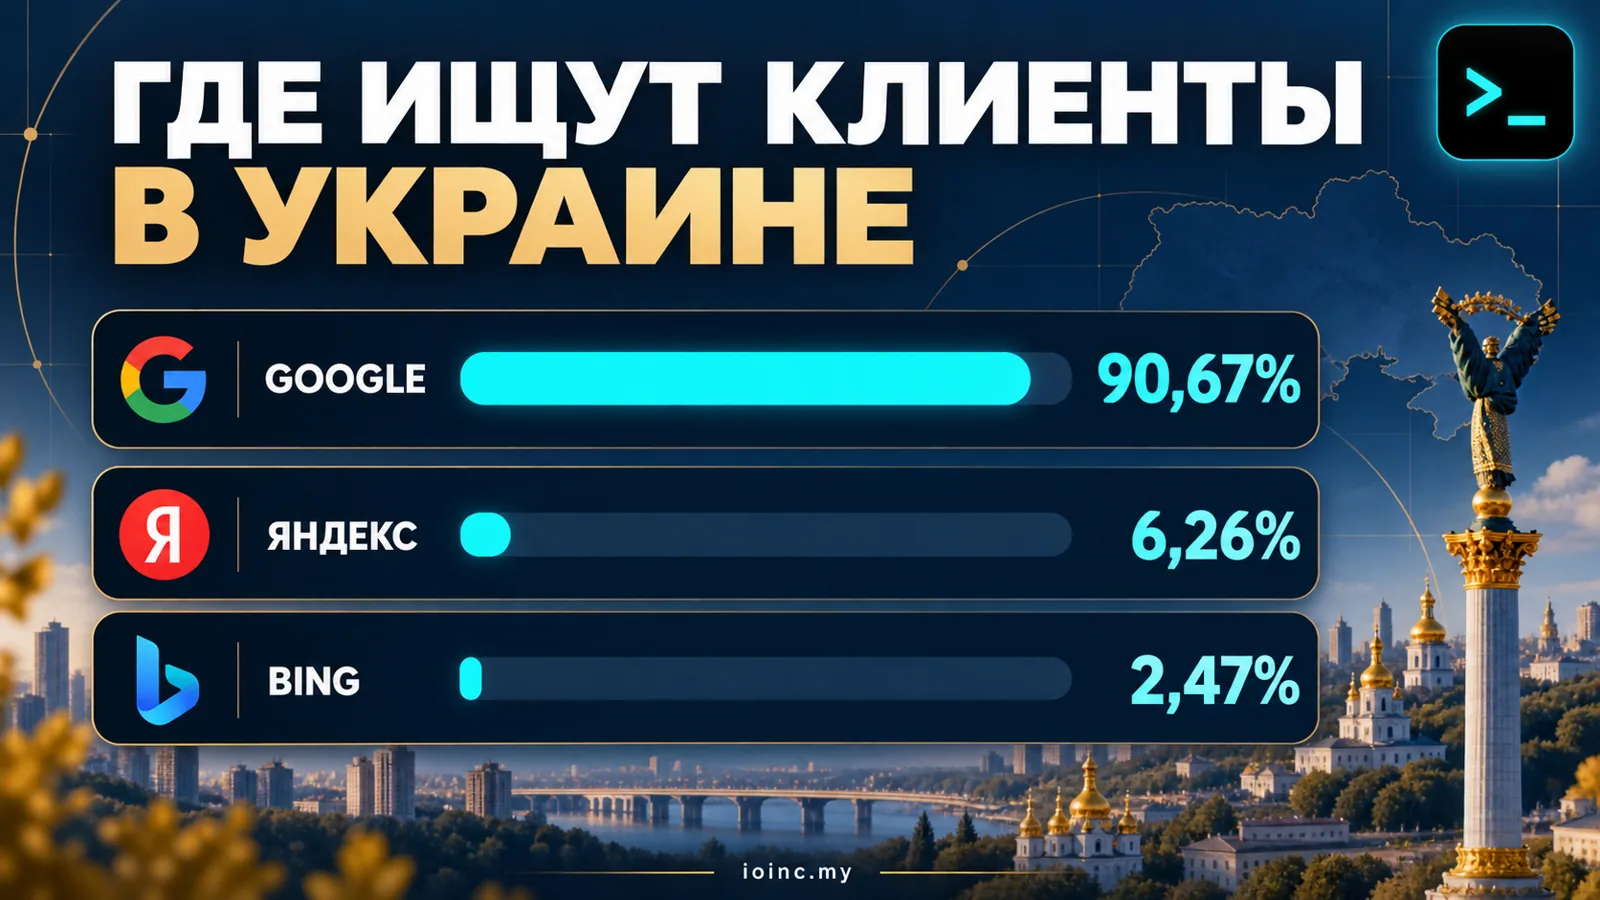
У задачи для Украины есть особенность, которая меняет методику: по данным Statcounter за сентябрь 2026 года на Google здесь приходится 90,67% поиска, на Яндекс — 6,26%, на Bing — 2,47%. Поэтому ядро строят на данных Google, а Яндекс Вордстат остаётся вспомогательным источником — им проверяют дополнительные формулировки и сезонность, но не определяют структуру сайта.
Что такое семантическое ядро и что считается результатом
Семантическое ядро — это упорядоченный набор поисковых запросов, по которым сайт хочет получать трафик, разложенный по смысловым группам и страницам. Ключевое слово здесь — «упорядоченный». Список из 5 000 фраз без группировки ядром не является: по нему нельзя ни спланировать структуру, ни написать техническое задание, ни запустить рекламу.
Рабочее ядро — это таблица, где у каждой строки есть не только сама фраза, но и служебные колонки. Если хотя бы одной из них нет, работа с ядром превращается в спор о вкусах.
- частотность в двух видах — широкая и точная, чтобы видеть и общий объём темы, и реальный спрос на конкретную формулировку;
- интент — коммерческий, информационный, навигационный или сравнительный;
- кластер — номер смысловой группы, в которую попала фраза;
- целевая страница — существующий адрес или ещё не созданный, но запланированный;
- приоритет — очередь работ, а не пожелание;
- гео-привязка, если спрос зависит от города;
- минус-слова — отдельным листом, они понадобятся и в рекламе.
Ядро — фундамент SEO-продвижения сайта: из него выходит структура разделов, темы статей, тексты метатегов и семантика рекламных кампаний. Когда ядро собрано наспех, дальше появляются страницы-двойники, статьи не о том, заявки не из тех запросов и вечное «вроде всё сделали, а трафика нет».
Почему в Украине ядро строят под Google, а не под Яндекс
Привычная методика из русскоязычных курсов начинается с Вордстата. Для украинского рынка это перевёрнутая последовательность: Вордстат показывает спрос в Яндексе, то есть примерно одну шестнадцатую часть всего поиска. Если строить структуру сайта только по нему, большая часть Google-спроса останется без страниц.
Практический вывод простой: основа ядра — данные Google, а Вордстат подключают на двух задачах. Первая — расширение: он отдаёт длинный хвост формулировок, которых нет в базовых отчётах Google. Вторая — проверка сезонности и ажиотажных всплесков, которые видно по графику динамики.
Второй слой особенности — язык запросов. О нём отдельный раздел ниже, потому что он влияет на сбор с самого первого шага и на итоговую структуру сайта.
Шаг 1. Маркеры: из чего вообще собирать ядро
Сбор всегда начинается с маркеров — коротких базовых формулировок, которые описывают бизнес. Ошибка на этом шаге дороже всего: потерянный маркер означает потерянный кусок спроса, который потом никто не заметит.
Маркеры удобно раскладывать по пяти группам, чтобы ничего не пропустить.
- услуга или товар — как категория называется в отрасли и как её называют клиенты;
- гео — город, район, область, «украина», «онлайн», «под ключ» в связке с городом;
- синонимы и профессиональный жаргон — то, что специалист называет «семантика», клиент ищет как «ключевые слова», а неопытный — как «слова для раскрутки»;
- проблема или боль — «почему сайт не продаёт», «мало заявок», «не видно в поиске»;
- сравнение и выбор — «что лучше», «чем отличается», «как выбрать», «сколько стоит».
Проверка качества маркеров занимает минуту: если по маркеру в топ-10 выдачи нет ни одной страницы, похожей на вашу услугу, значит маркер сформулирован не на языке спроса. Такой список нужно переписать, а не расширять.
Шаг 2. Источники фраз: где брать данные в 2026 году
Шесть источников закрывают практически любую нишу. Комбинировать их нужно потому, что каждый видит спрос под своим углом.
- Яндекс Вордстат — длинный хвост и сезонность в Яндексе;
- подсказки Google и YouTube — реальные формулировки, которые люди набирают прямо сейчас;
- Планировщик ключевых слов Google — объёмы и оценка стоимости клика по Google-спросу;
- Google Search Console — фактические запросы, по которым вас уже находят;
- семантика конкурентов — их видимость, из которой видно пробелы вашей структуры;
- внутренний поиск по сайту и вопросы из CRM — формулировки клиентов, которых нет ни в одном сервисе.
По Вордстату важна актуальная механика. С 2024 года у него новый интерфейс: вместо двух колонок — вкладки «Динамика», «Регионы» и «Топы запросов», а прежний вид остался на отдельном адресе как «Подбор слов». В динамике по месяцам и неделям доступен период от трёх месяцев до пяти лет, по дням — последние 60 дней. API переехал в Yandex Search API: старая документация по адресу yandex.ru/dev/wordstat отдаёт 404, это проверено 1 сентября 2026 года. И важное ограничение: в API операторы Вордстата не работают, поэтому точную и фразовую частотность на больших объёмах снимают через интерфейс или сторонние парсеры.
Планировщик Google выдаёт не точные цифры, а диапазоны — например, «100–1K» или «1K–10K», и полноценный доступ к нему требует аккаунта Google Рекламы с платёжными данными. Для структуры сайта диапазона достаточно: он отвечает на вопрос «десятки, сотни или тысячи», а точное число всё равно не гарантирует трафик.
Search Console — единственный бесплатный источник, где видно не предполагаемый, а фактический спрос по вашему сайту: показы, клики, средняя позиция за последние месяцы. Этот отчёт показывает, какие запросы вы уже почти получаете, и где не хватает страницы.
Семантику конкурентов снимают для проверки полноты, а не для копирования. Их кластеры построены под их структуру и их ассортимент; перенос чужого ядра на другой сайт даёт пачку страниц, которые конкурируют друг с другом. Как оценить такую структуру заранее, разбирает материал про аудит сайта.
Шаг 3. Частотность: какую цифру брать в работу
Одна и та же фраза имеет три разных числа, и путаница между ними — самая частая причина завышенных ожиданий.
- широкая частотность — сколько раз искали фразу и любые запросы, где встречаются эти слова в любом порядке и форме;
- фразовая — фиксированный состав и порядок слов, но с любыми словоформами;
- точная — конкретная словоформа целиком, без добавлений и перестановок.
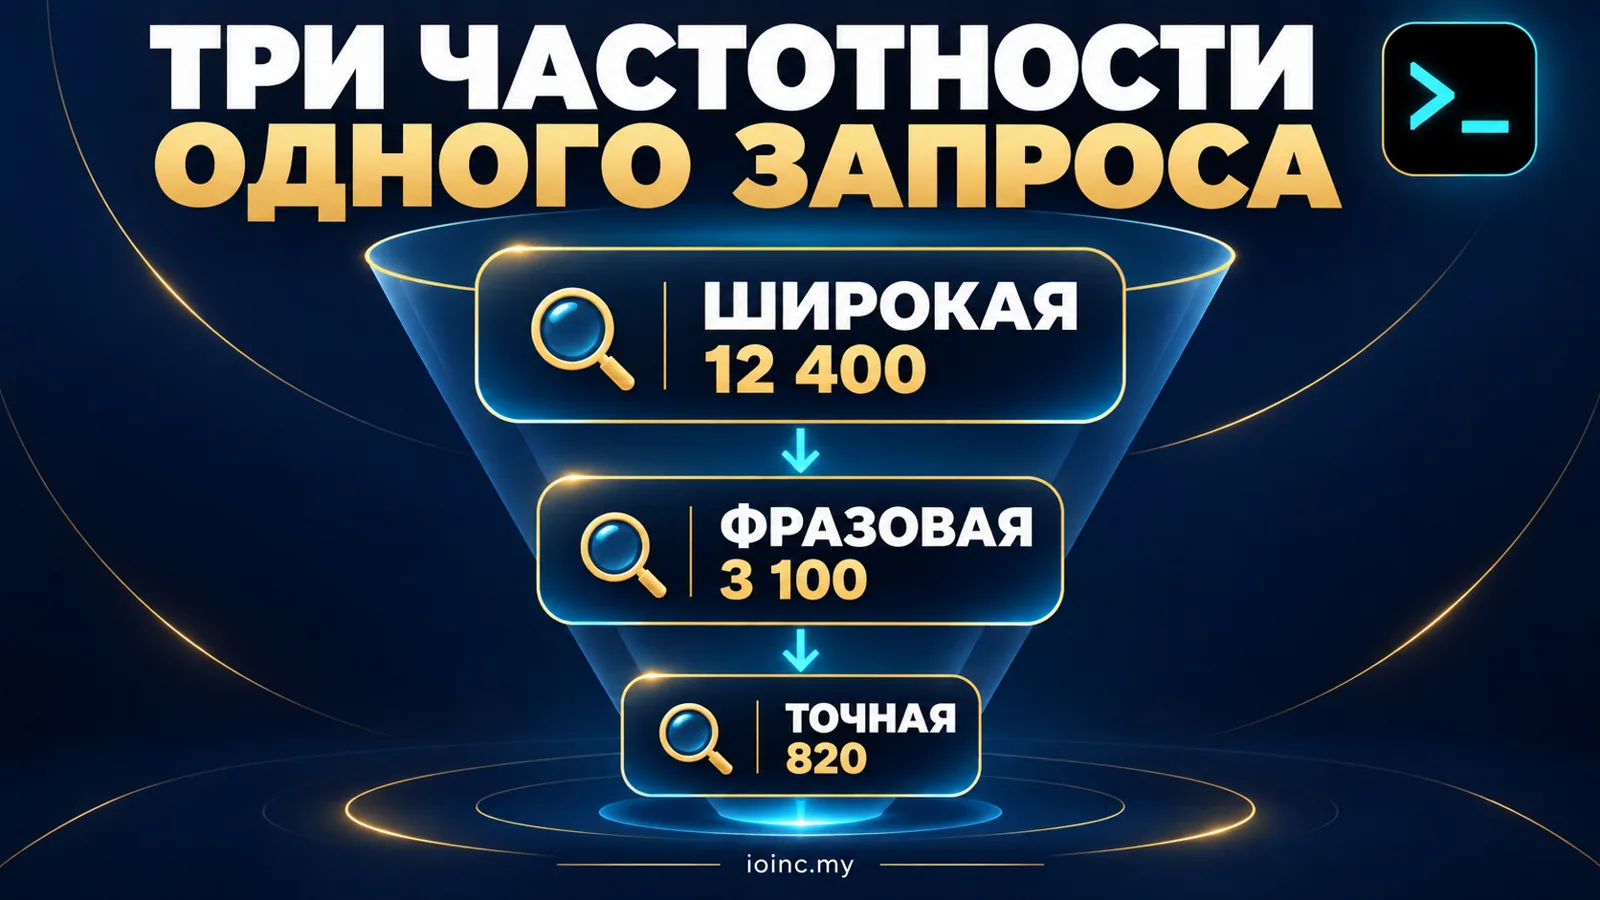
В Вордстате эти срезы делаются операторами: кавычки фиксируют состав и порядок слов, восклицательный знак перед словом — точную словоформу, плюс делает слово обязательным, минус исключает слово из выдачи. Один и тот же запрос может дать 12 400 в широкой, 3 100 в фразовой и 820 в точной — и работать вы будете именно с последней цифрой, а видеть потенциал темы — по первой.
Сезонность смотрят до того, как строить план: у многих услуг пик приходится на два-три месяца в году. Для сезонных тем ядро делят на «сезонное» и «круглогодичное», иначе контент-план на январь будет написан под августовский спрос.
И главная ловушка: широкая частотность не равна коммерческому трафику. В объём запроса «разработка сайтов» попадают вакансии, курсы, бесплатные конструкторы, «своими руками» и школьные рефераты. Проверка одна — открыть топ-10 по фразе и посмотреть, какие страницы там стоят: если это статьи и вакансии, коммерческой ценности у запроса почти нет.
Шаг 4. Чистка: что выкинуть до кластеризации
Чистка занимает больше времени, чем сбор, и именно она отличает рабочее ядро от мусорного файла. Правило простое: фраза остаётся, только если по ней в выдаче есть страница, на которую вы можете ответить содержательно.
- нерелевантные услуги — всё, чего у вас нет и не будет в ближайший квартал;
- чужие гео — другие города и страны, если вы там не работаете физически или удалённо;
- бесплатное и самостоятельное — «своими руками», «бесплатно», «скачать», «своими силами»;
- нецелевая аудитория — «вакансии», «курсы», «зарплата», «отзывы сотрудников», «что это такое»;
- бренды конкурентов — в SEO это шум, в рекламе отдельная кампания со своим бюджетом;
- информационные запросы внутри коммерческого кластера — они уводят на статьи, а не на страницу услуги;
- дубли и словоформы, а также фразы на другом языке, если для них нет отдельной версии сайта.
Отсеянное не выбрасывают: из него получается лист минус-слов, который потом экономит бюджет в поисковых кампаниях. Как это применяется на практике — в материале про настройку Google Ads, где минус-слова разбираются на уровне структуры аккаунта; общая логика кампаний и ставок разобрана в статье про контекстную рекламу в Украине.
Отдельно про опечатки: частотные искажения («разработка сайтив», «семантика ядра») иногда стоит оставить — они приводят живых людей. Редкие опечатки в ядро не берут, они только увеличивают объём таблицы.
Шаг 5. Кластеризация: hard, soft и порог совпадений
Кластеризация отвечает на вопрос, который нельзя решить по смыслу слов: нужна одна страница или две. Ответ даёт поисковая выдача. Если по двум разным фразам в топ-10 стоят одни и те же адреса, поисковик считает потребность общей, и делать под них две страницы бессмысленно — они начнут конкурировать между собой.
На пересечении топов работают два метода. Жёсткая кластеризация (hard) объединяет фразы в группу, только если общие адреса есть у каждой пары внутри группы: кластеры получаются маленькими, но надёжными — так группируют коммерческие запросы, где цена ошибки высокая. Мягкая (soft) требует совпадения только с центральной фразой группы, поэтому кластеры выходят крупнее, и для информационных статей этого обычно достаточно.
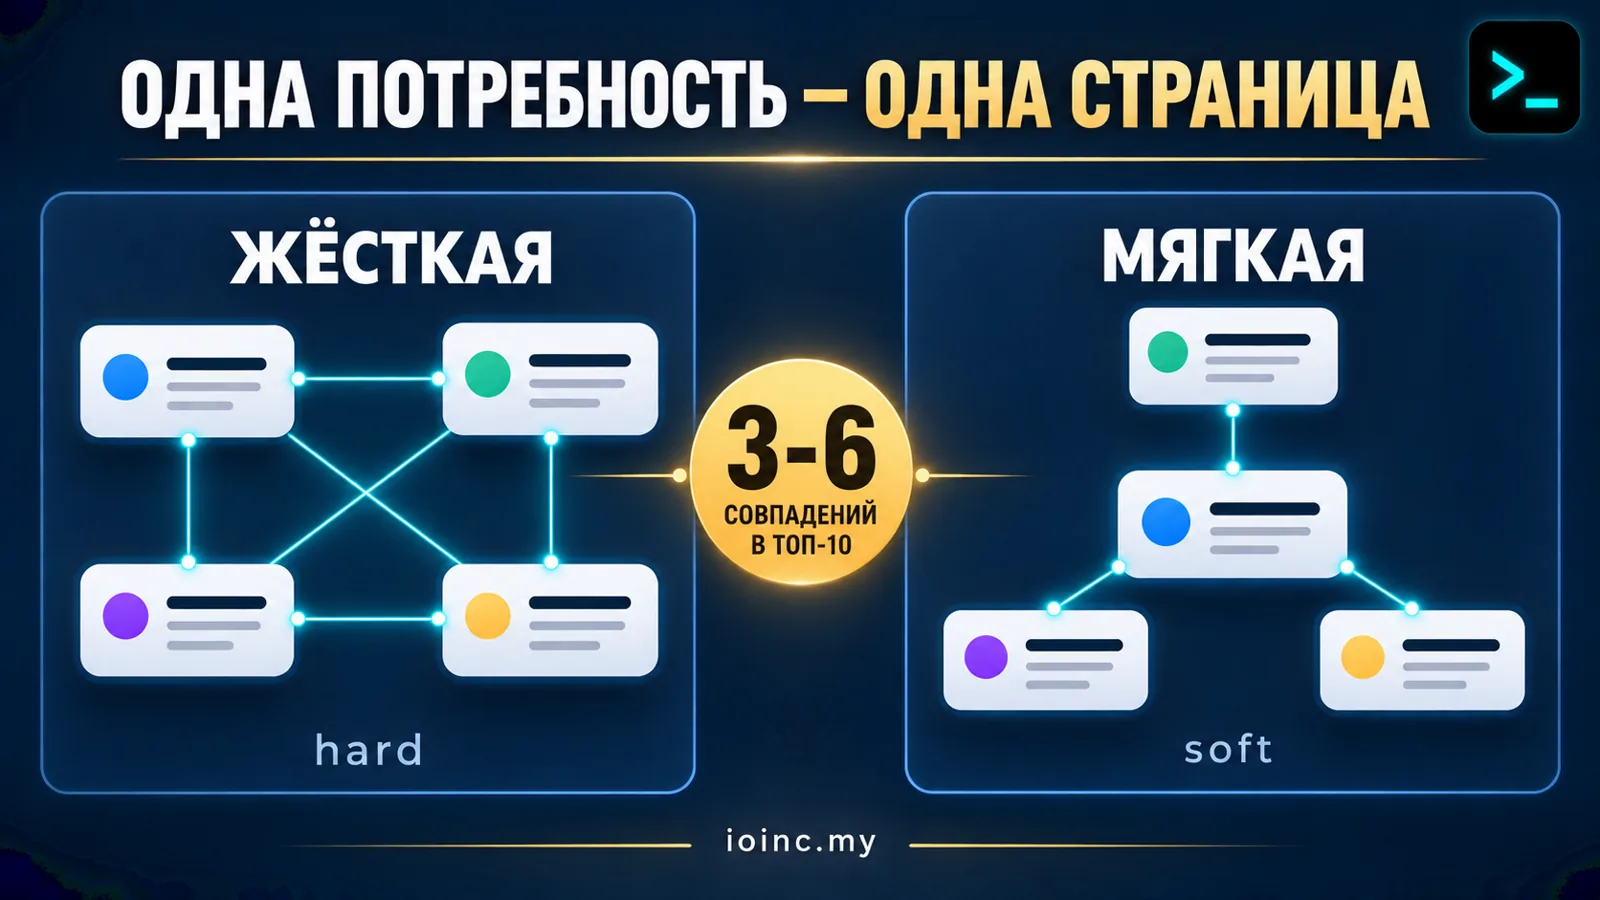
Порог совпадений выбирают в диапазоне от 3 до 6 общих адресов из топ-10. Чем он выше, тем строже группировка: для магазина с сотнями похожих категорий берут 4–5, для блога хватает 3. Слишком высокий порог дробит тему на десятки мелких кластеров, слишком низкий — склеивает разные услуги в одну страницу.
На ядре до 200–300 фраз кластеризацию дешевле сделать руками: отсортировать по убыванию частотности и пройти сверху вниз, проверяя спорные пары по выдаче. Спорных пар обычно немного — основная масса хвоста очевидно липнет к своим маркерам. Всё, что больше тысячи фраз, уже разумно отдавать сервису.
И важная поправка, которую пропускают: кластер — это потребность, а не страница. Если в кластере два-три слова, отдельная страница под него будет пустой. Такие группы объединяют по интенту или добирают расширением семантики до объёма, при котором страница имеет смысл.
Шаг 6. От кластеров к структуре сайта
Дальше ядро превращается в структуру. Коммерческие кластеры уходят на страницы услуг и категорий, информационные — в журнал и базу знаний, гео-кластеры — на локальные страницы и карточки в картах. Одна страница получает один основной кластер и 1–3 смежных, если они не создают конкуренции.
Здесь же ловится каннибализация. Признак пары-каннибала простой: два адреса отвечают на одну потребность, и больше половины заголовков у них совпадают по смыслу. Классический пример — общая статья по стране и городская с теми же разделами: «сколько стоит», «как выбрать подрядчика», «ошибки». Лечится не переписыванием обеих, а разведением по интенту: широкая тема остаётся первой частью, городская становится второй — со своей местной спецификой и ссылкой на первую. Как это выглядит на практике, видно в материале SEO-продвижение в Украине, у которого есть отдельная вторая часть по столице.
Гео-спрос не всегда закрывается статьёй. Часть его живёт в картах и локальном пакете выдачи, и там работают другие сигналы — заполненный профиль, отзывы, категории, радиус обслуживания. Это отдельная ветка плана, подробнее — в статье про продвижение в Google Maps.
Готовое ядро сразу даёт три артефакта: карту структуры сайта, контент-план с приоритетами и технические задания на тексты. Если после сбора ядра этих трёх документов нет, ядро собрано зря.
Язык ядра: украинский, русский и требование закона
Языковой вопрос в украинском SEO — не вкусовой, а нормативный. Статья 27 Закона Украины «Про забезпечення функціонування української мови як державної» № 2704-VIII требует, чтобы интернет-представительства субъектов хозяйствования, реализующих товары и услуги в Украине, выполнялись на государственном языке, а украинская версия для пользователей в Украине загружалась по умолчанию. Норма вступила в силу 16 июля 2022 года, и другие языковые версии могут существовать рядом с украинской.
Для семантики это означает два отдельных ядра. Украинское собирают с нуля — на маркерах «послуги», «ціна», «замовити», «під ключ», «що краще»; русское собирают отдельно, а не переводят с украинского. Дословный перевод даёт фразы, которых никто не ищет: частотность у языковых версий различается в разы, и предсказать её без проверки нельзя.
Технически две версии связывают через hreflang, а не через редирект: иначе поисковик видит одну страницу и второе ядро просто не работает. Приоритет языков в плане ставят по данным Search Console: там видно, на каком языке к вам уже приходят, а на каком показов нет.
Сколько стоит сбор ядра в 2026 году
Три пути отличаются не только ценой, но и тем, что остаётся на выходе. Самостоятельный сбор даёт список с частотностями и требует вашего времени. Сервис даёт инструменты и кластеризацию, но решения принимаете вы. Агентство отдаёт готовую структуру с распределением по адресам и заданиями на тексты.
Порядок цен на инструменты (проверено 24 октября 2026 года, российские сервисы считают в рублях):
- Яндекс Вордстат — бесплатно, нужен аккаунт Яндекса;
- Планировщик ключевых слов Google — бесплатно, но основной функционал открывается после создания аккаунта Google Рекламы с платёжными данными;
- Key Collector — 2 200 ₽ за первую лицензию, 1 700 ₽ за вторую–десятую, программа работает на вашем компьютере;
- Rush Analytics — от 500 ₽ (Lite) до 49 999 ₽ в месяц (Corp); кластеризация стоит 0,35 внутреннего лимита за фразу;
- Just-Magic — подписки от 1 000 до 10 000 ₽ в месяц, кластеризация 0,1–0,3 ₽ за фразу;
- MOAB.Tools Cluster — пакеты на 10 000 фраз за 499 ₽ и на 300 000 фраз за 5 999 ₽, баланс не сгорает;
- ARSENKIN TOOLS — 990, 2 490 и 7 990 ₽ в месяц, экспресс-группировка до 300 фраз, большое ядро — до 70 000;
- KeyCore — тарифы 490, 990 и 2 490 ₽, есть AI-кластеризация и определение интентов;
- Ahrefs — Starter 29 $, Lite 129 $, Standard 249 $, Advanced 449 $ в месяц.
Дорогие зарубежные базы оправданы, когда нужен анализ конкурентов и международные рынки; для одной локальной ниши в Украине почти всегда достаточно Вордстата, Search Console и пакета в кластеризаторе за несколько сотен рублей.
Цены агентств на эту услугу расходятся в разы: по открытым прайсам рынка сбор семантического ядра стоит от 5 000 до 95 000 ₽ — это рыночный диапазон, а не прайс конкретной компании. За 5 000 обычно отдают список с частотами, за 95 000 — карту спроса с распределением по существующим и будущим страницам, приоритетами и заданиями на тексты. На биржах фриланса встречаются предложения за 500 ₽ на 100 ключей, но группировка, ручная доработка и анализ релевантных страниц там идут отдельными платными опциями. Точная смета зависит от сложности задачи: количества услуг, числа регионов и объёма ядра.
Как приоритизировать работу по ядру
Ядро на 3 000 фраз нельзя сделать за месяц, и это нормально. Приоритет считают не по одной частотности, а по четырём факторам: объём точной частотности, коммерческий интент, текущая позиция страницы и маржинальность услуги.
- Сначала страницы услуг, которые приносят деньги и уже имеют позиции в топ-20 — там быстрый эффект от доработки;
- затем категории с высоким спросом и слабой конкуренцией в выдаче;
- потом информационные кластеры, поддерживающие коммерческие страницы перелинковкой;
- в конце — длинный хвост и гео-кластеры, которые дают трафик, но требуют отдельных страниц.
Приоритет без измерения бессмысленен: без корректной аналитики невозможно понять, какой кластер дал заявки, а какой — только визиты. Настройка аналитики и трекинга идёт параллельно со сбором ядра, а не после.
Ошибки, которые обнуляют ядро
- собирать только по Вордстату на рынке, где 90% поиска — Google;
- брать широкую частотность за потенциал трафика;
- кластеризовать по смыслу слов, не проверяя пересечение выдачи;
- оставлять в ядре информационные запросы под коммерческие страницы;
- делать отдельную страницу под каждый кластер из двух слов;
- переводить ядро с русского на украинский вместо отдельного сбора;
- не фиксировать интент и целевой адрес, оставляя ядро таблицей без решений.
Чек-лист приёмки семантического ядра
- у каждой фразы есть широкая и точная частотность;
- указан интент и кластер;
- у каждого кластера есть целевой адрес — существующий или запланированный;
- кластеры собраны по выдаче, порог совпадений зафиксирован;
- проведена чистка, минус-слова вынесены отдельным листом;
- гео-запросы отделены от общих;
- украинская и русская части собраны независимо;
- есть приоритет и очередь работ на квартал;
- ядро выгружено в таблицу, а не существует в переписке;
- определена дата следующего пересмотра.
Проверить ядро можно ещё до публикации: если по кластеру нельзя за минуту сказать, какая страница на него отвечает, значит распределение не сделано.
Что делать после сбора
Ядро устаревает: меняются услуги, гео, конкуренты и сам спрос. Пересматривают его раз в квартал, а вне графика — при запуске новой услуги, смене цен, выходе в новый регион или заметном падении трафика. Обновление — это не новый сбор с нуля, а сверка: какие кластеры выросли, какие просели, какие страницы так и не появились.
Есть и техническая связка, о которой забывают: если сайт только предстоит делать, ядро собирают до проектирования структуры, иначе разделы придумываются раньше спроса. Как это встраивается в проект, разбирает материал про SEO на этапе разработки сайта, а проверить уже существующую структуру на соответствие спросу помогает аудит digital-проекта.
Честный вывод: семантическое ядро — самая скучная и самая влиятельная часть SEO. Оно не даёт мгновенного результата, но ошибка в нём масштабируется на весь сайт: каждая лишняя страница тратит краулинговый бюджет, каждая пропущенная потребность — это трафик, который забирает конкурент. Работа окупается не скоростью, а тем, что дальше не приходится переделывать структуру.
Обсудить сбор семантического ядра под ваш сайт
Частые вопросы
Чем семантическое ядро отличается от списка ключевых слов?
Список — это только фразы и частотности. Ядро дополнительно содержит интент, кластер, целевой адрес и приоритет, поэтому по нему можно строить структуру сайта и ставить задачи на тексты.
Сколько запросов должно быть в семантическом ядре?
Норма зависит от размера сайта: для локальной услуги это 200–800 фраз, для интернет-магазина — десятки тысяч. Важнее не количество, а то, что у каждой группы есть страница, на которую она ведёт.
Можно ли собрать семантическое ядро бесплатно?
Да, для небольшого сайта хватает Вордстата, подсказок Google и Search Console. Платные инструменты нужны, когда фраз больше нескольких сотен и требуется автоматическая кластеризация по выдаче.
Что такое кластеризация по выдаче?
Это группировка запросов по совпадению адресов в топ-10: если по двум фразам ранжируются одни и те же страницы, потребность общая и создавать под неё две страницы не нужно.
Какой порог совпадений использовать при кластеризации?
Обычно от 3 до 6 общих адресов из топ-10. Для магазинов с похожими категориями берут 4–5, для информационных статей достаточно 3.
Почему нельзя ориентироваться только на Яндекс Вордстат?
Потому что Вордстат показывает спрос Яндекса, а в Украине на Google приходится 90,67% поиска по данным Statcounter за сентябрь 2026 года. Структура, собранная только по Вордстату, закрывает малую часть спроса.
Нужно ли собирать ядро на украинском и русском отдельно?
Да. Частотность и формулировки у двух языков разные, дословный перевод даёт фразы, которых никто не ищет. Плюс статья 27 закона № 2704-VIII требует украинской версии сайта по умолчанию для пользователей в Украине.
Сколько времени занимает сбор семантического ядра?
Для сайта услуг с одной-двумя нишами — от 3 до 7 рабочих дней вместе с чисткой и кластеризацией. Для интернет-магазина с большим каталогом — от двух недель, потому что добавляется распределение по сотням категорий.
Как понять, что запрос коммерческий?
По выдаче: если в топ-10 стоят страницы услуг, каталоги и карточки товаров — интент коммерческий. Если статьи, видео и форумы — информационный, и вести такой запрос нужно на статью, а не на страницу услуги.
Что делать с запросами, по которым уже есть страница?
Сверить, соответствует ли страница интенту кластера, добавить недостающие формулировки в текст и метатеги. Новую страницу под тот же кластер создавать не нужно — она заберёт трафик у существующей.
Как часто нужно обновлять семантическое ядро?
Планово — раз в квартал. Вне графика — при запуске новой услуги, изменении цен, выходе в новый регион или резком падении органического трафика.
Можно ли поручить сбор ядра нейросети?
Нейросеть помогает с маркерами, формулировками и черновой группировкой, но частотность и пересечение выдачи она не измеряет. Проверять спрос и кластеры всё равно нужно по данным поиска.